推論チップの英Fractileが7億2,000万ドルを追加調達、企業評価額は70億ドルに
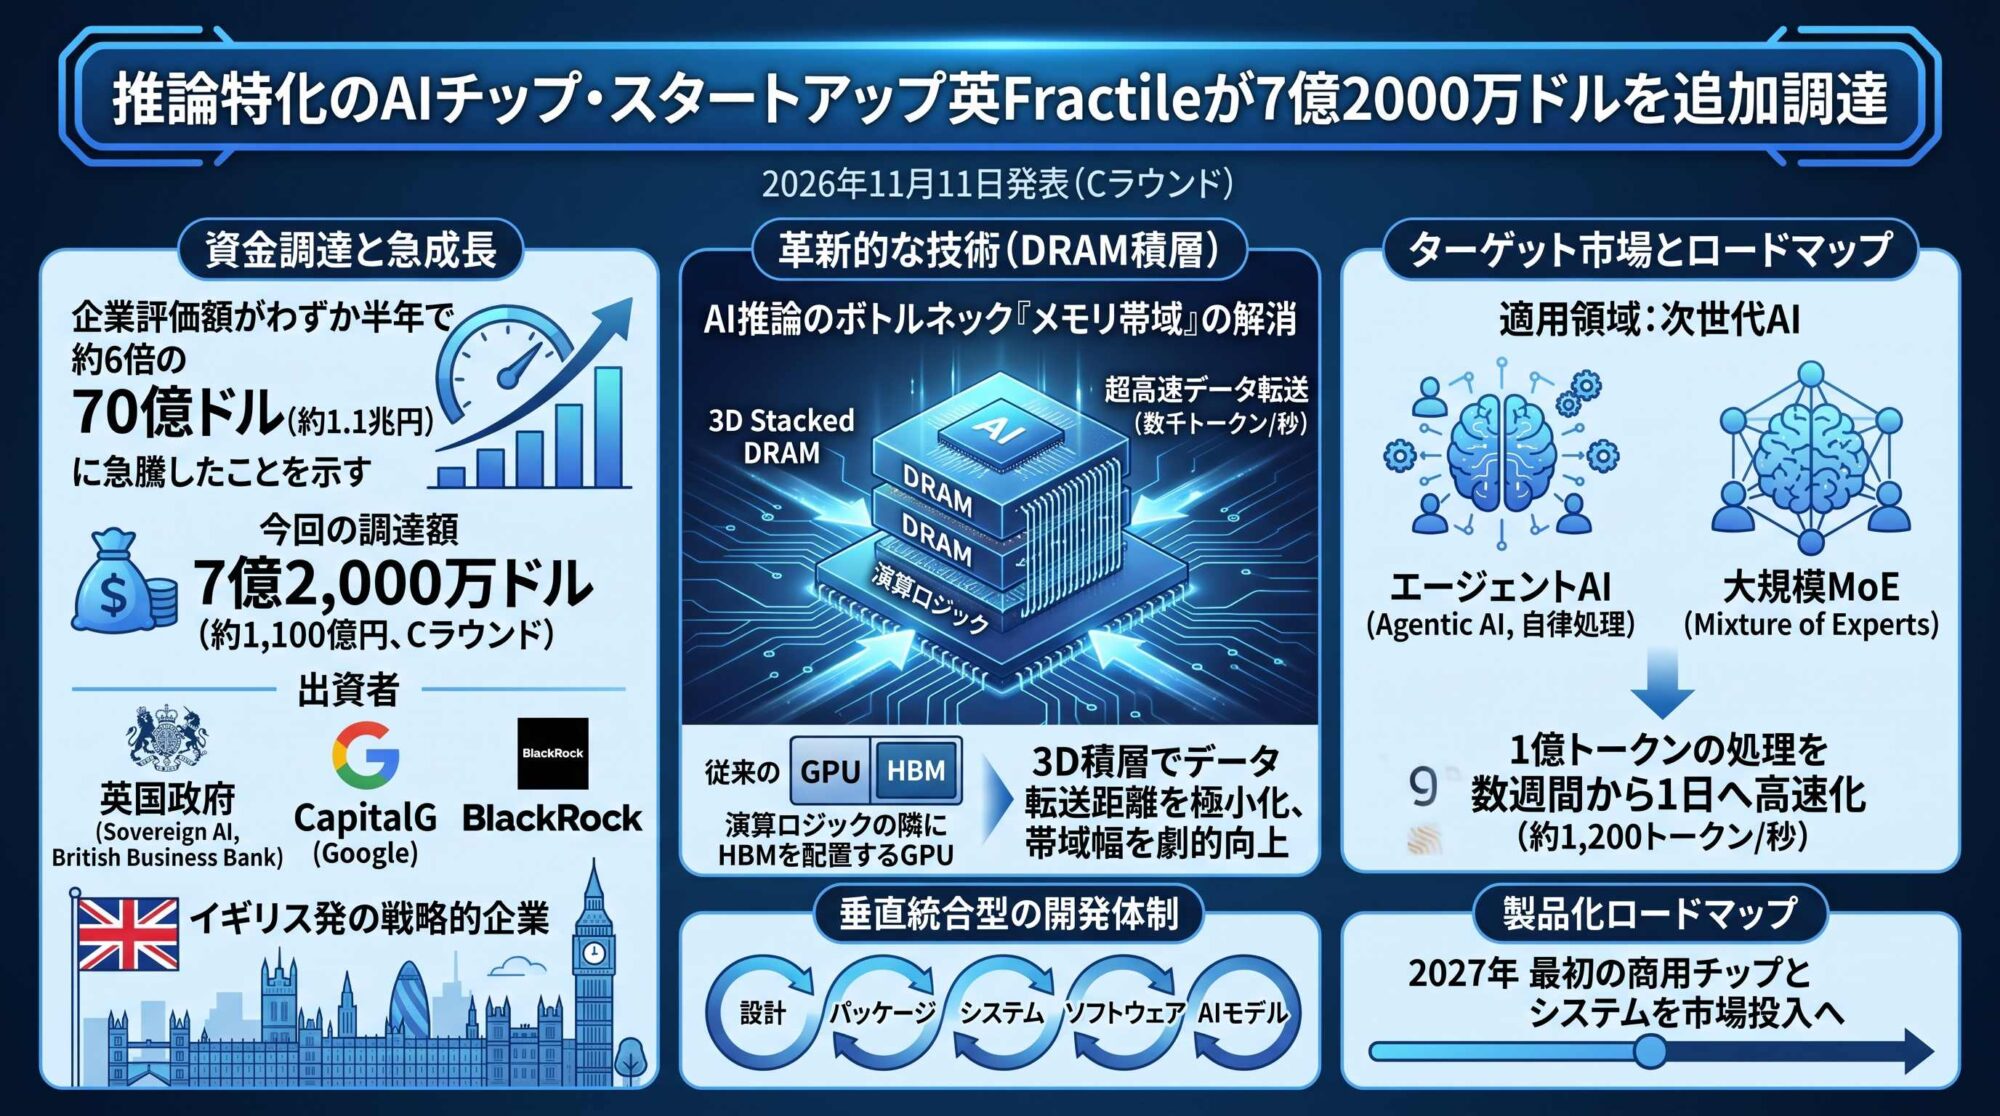
2026年11月11日、推論特化のAIチップ・スタートアップ英Fractileは、資金調達Cラウンドで7億2,000万ドル(約1,100億円)の資金を調達したことを明らかにした。今回の資金調達における同社の企業評価額は70億ドルに達した。
今回のラウンドには英国政府が推進するSovereign AIとBritish Business Bankも参加。Google傘下の投資会社CapitalGのほか、BlackRockなども出資している。
Fractileは2026年5月にもシリーズBラウンドで2億2,000万ドルを調達しており、当時約11億ドルだった企業評価額は、わずか半年で約6倍に拡大した。(関連ニュース)
なおFractileは、2025年にIntelの元CEOであるPat Gelsinger氏から出資を受けており、半導体業界の著名人からも支援を受けている。
Fractileは大規模AIモデルの推論処理に特化したチップを開発しており、独自の3次元メモリアーキテクチャによって、従来のGPUを大幅に上回る推論性能と電力効率の実現を目指している。
Fractileの特徴は、単にAI推論向けの専用チップを開発するだけではなく、チップアーキテクチャ、回路設計、物理設計、先端パッケージング、システム、ソフトウェア、さらにはAIモデルそのものの研究までを手掛ける垂直統合型の開発体制にある。
Goodwin氏によると、2026年10月時点で同社には約150人の技術者が在籍しており、NVIDIA、Broadcom、Graphcore、Intelなどで経験を積んだエンジニアも開発に参加している。
AI推論のボトルネック「メモリ帯域」を抜本的に改善
Fractileが注力しているのは、AI推論におけるメモリ帯域の制約を解消することだ。
現在のNVIDIA製GPUなどでは、この問題に対処するためにHBMが採用されているが、AIモデルの大規模化やコンテキスト長の拡大によって、HBMの帯域幅と容量も制約となりつつある。
一方、GroqやCerebrasなどが採用するオンチップSRAM中心のアーキテクチャは、非常に高いメモリアクセス性能を実現できる反面、SRAMの面積効率やコストの問題から、大容量メモリの搭載が難しい。
Fractileは、このHBMとSRAMのトレードオフを解消しようとしている。
同社が開発する新しいAI推論プロセッサは、DRAMを演算ロジックの直上に3次元積層する独自のアーキテクチャを採用する。HBMスタックが演算ロジックの隣に配置される一般的なGPUとは異なり、DRAMと演算回路をより密接に結合することで、データ転送の距離や制約を減らし、高いメモリ帯域を実現する考えだ。
2026年10月に公開されたインタビューでGoodwin氏は、同社のアーキテクチャによって、HBMを使用する従来型チップと比較してチップ当たり約25倍のメモリ帯域を実現できるとの見通しを示している。
当初のSRAM方式からDRAM積層方式へ技術転換
興味深いのは、Fractileが創業当初から現在のDRAM積層方式を採用していたわけではない点だ。
Goodwin氏によると、同社は創業から約2年間、GroqやCerebrasに近いSRAMベースの推論チップを開発していた。しかし、2023年後半から2024年にかけて、AIモデルのパラメータ数だけでなく、推論時に扱うコンテキスト長も急速に拡大すると予測したことから、SRAMを中心とするアーキテクチャの拡張性に懸念を抱くようになったという。
そこで同社は、メモリメーカーやロジック半導体の製造パートナーと協力して、高い帯域幅と大容量を両立できるDRAMベースの新しいアーキテクチャの研究開発へと軸足を移した。
新しい方式は、SRAMベースの推論アクセラレータに近い高速性を確保しながら、DRAMの大容量と低いビット単価を活用できる点に特徴がある。
Fractileは、この技術によって数千トークン/秒という高速な推論を、巨大なAIモデルや長いコンテキストを扱う環境でも実現することを目指している。
Agentic AIや大規模MoEモデルへの適用を想定
Fractileが狙っている市場は、複雑な問題を解決するために大量の推論を繰り返すReasoningモデルや、自律的に複数の処理を実行するAgentic AIの領域だ。
こうした用途では、AIモデルが多数のトークンを逐次生成し、長いコンテキストを保持しながら推論を続ける必要がある。Goodwin氏は、現在のハードウェアで約40トークン/秒の速度で処理される1億トークン規模の計算には、数週間から1か月程度を要すると指摘。これを約1,200トークン/秒へ高速化できれば、計算時間を約1日に短縮できるとしている。
また、Fractileは、推論時に必要な一部の演算回路だけを動かして計算量を削減するMoE(Mixture of Experts)型のAIモデルにも注目している。
MoEでは演算量を削減できる一方、メモリからのデータ読み出しが処理速度の制約となりやすい。Fractileは独自技術でメモリ帯域を大幅に拡大することで、この問題を解消し、より少ない演算量で効率的なAI推論を実現しようとしている。
2027年の製品投入を目指す
Fractileは独自のAI推論チップに加え、ラックスケールのシステムや、それらを効率的に利用するためのソフトウェアも開発している。半導体のフロントエンド設計から物理実装、先端パッケージングまでを社内で手掛けることで、AIワークロードの変化に対応したアーキテクチャの最適化と開発期間の短縮を目指している。
同社は2027年に最初の商用チップとシステムの投入を計画しており、今回調達した資金は製品化や量産体制の構築などに活用されるとみられる。
AI半導体市場ではNVIDIAが依然として圧倒的な地位を築いているが、AIの利用形態が学習中心から大規模推論へと広がる中、メモリ帯域を重視した新しいアーキテクチャの重要性は増しており、英国政府も出資するなどFractileは英国発の有力AI半導体企業として注目を集めている。
独自のDRAM積層技術を強みに、NVIDIAや既存の推論専用アクセラレータに対してどのような競争力を示せるのか。2027年に予定される製品投入が、その実力を測る最初の重要な機会となりそうだ。
Fractile
= EDA EXPRESS 菰田 浩 =
(2026.11.12
NEW
)