AIによるRTL設計/検証能力のベンチマーク「CVDP」がアップデートされる
2026年6月8日、オープンソース・ベンチマーク「CVDP 1.1.0」が公開された。
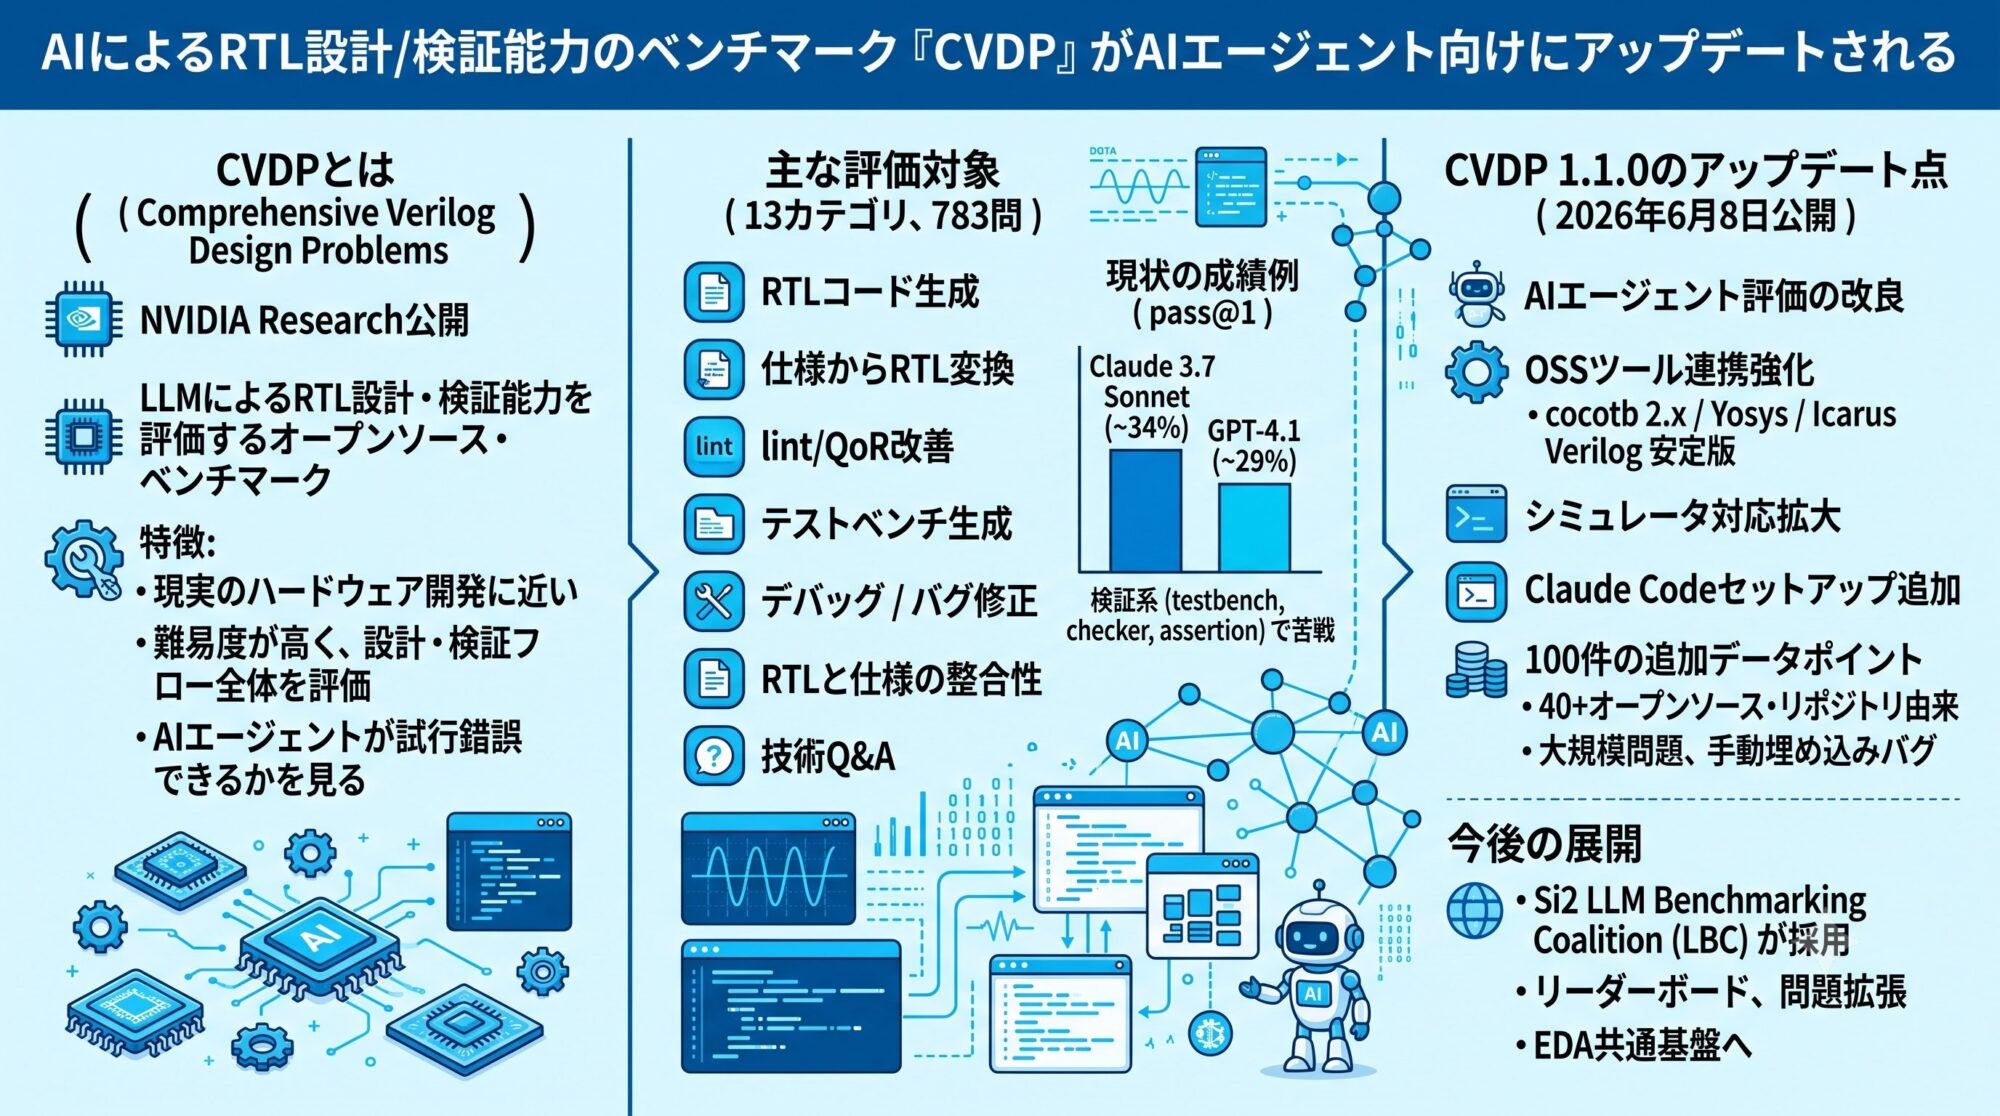
「CVDP(Comprehensive Verilog Design Problems)」は、2025年6月にNVIDIA Researchが公開したLLMによるRTL設計・検証能力を評価するためのオープンソース・ベンチマークで、最初のリリースでは、Verilog/SystemVerilogを対象に、RTL生成、検証、デバッグ、仕様整合、技術Q&Aなどを含む13カテゴリ、783問の問題セットが提供された。問題は経験あるハードウェア・エンジニアによって作成され、単発回答型の「Non-Agentic」と、ツールを使いながら問題を解く「Agentic」の両形式を備えている。(論文上、問題数の内訳は、Non-Agenticが617問、Agenticが166問)
「CVDP」は、「VerilogEval」や「RTLLM」など既存のベンチマークよりも現実のハードウェア開発に近い、難しめのRTL/検証ベンチマークで、単にRTLコードを書けるかだけではなく、設計・検証フロー全体に近い能力を問う点が特徴。AIエージェントが設計・検証フローの中で試行錯誤できるかを見るベンチマークとして有効とされている。「CVDP」の主な評価対象は以下の通り。
・RTLコード生成
・仕様からRTLへの変換
・既存RTLの修正・再利用
・lint/QoR改善
・テストベンチ生成
・checker生成
・SystemVerilog Assertion生成
・デバッグ/バグ修正
・RTLと仕様の対応関係の確認
・RTLやテストベンチに関する技術Q&A
従来のベンチマークが比較的狭い範囲の自己完結型問題が中心で、やや解けすぎるのに対し、「CVDP」はより現実的で難しい設計・検証タスクを人手で作成し、現在の最先端モデルでも十分に解けないように設計されている。NVIDIAの論文によると、Non-Agentic Code Generation全体の最高pass@1はClaude 3.7 Sonnetの約34%、GPT-4.1が約29%、Llama 3.1 405Bが約23%にとどまっている。また論文では、テストベンチ生成、checker生成、assertion生成といった検証系カテゴリでpass rateが低く、最先端LLMでも構文的に正しいSystemVerilog testbenchを書くことに苦労していると分析されている。
今回アップデートされた「CVDP 1.1.0」では、特にAIエージェント評価を意識した改良が加えられた。cocotb、Yosys、Icarus VerilogといったOSSツールの安定版を利用するようになり、cocotb 2.x対応によって、オープンソース/商用を含むより多くのシミュレータへの対応拡大も見込まれている。また、Claude Codeを使った評価実行の初期セットアップもフレームワークに追加された。
さらに「CVDP 1.1.0」では、40以上のオープンソース・リポジトリから作成された100件の追加データポイントが加わった。これらには手動で埋め込まれたバグや、より大規模な問題が含まれており、高レベル記述からRTLを生成したり、既存コードベースを理解して修正したりするAIエージェントの能力を評価する狙いがあるという。
この「CVDP」は、業界団体Si2(Silicon Integration Initiative)の中で半導体設計向けLLMの評価手法を改善する取り組みを進めている「LLM Benchmarking Coalition(LBC)」が採用している。Si2は「CVDP」を土台に、新しい問題カテゴリや設計領域への拡張、評価指標の精緻化、リーダーボードの整備を進めるとしており、「CVDP」は単なる研究用ベンチマークにとどまらず、半導体業界におけるAI for EDA評価の共通基盤へと発展していく可能性がある。
= EDA EXPRESS 菰田 浩 =
(2026.06.30
)