元Google TPU開発エンジニアが率いるLLM専用チップのMatXが5億ドルを調達
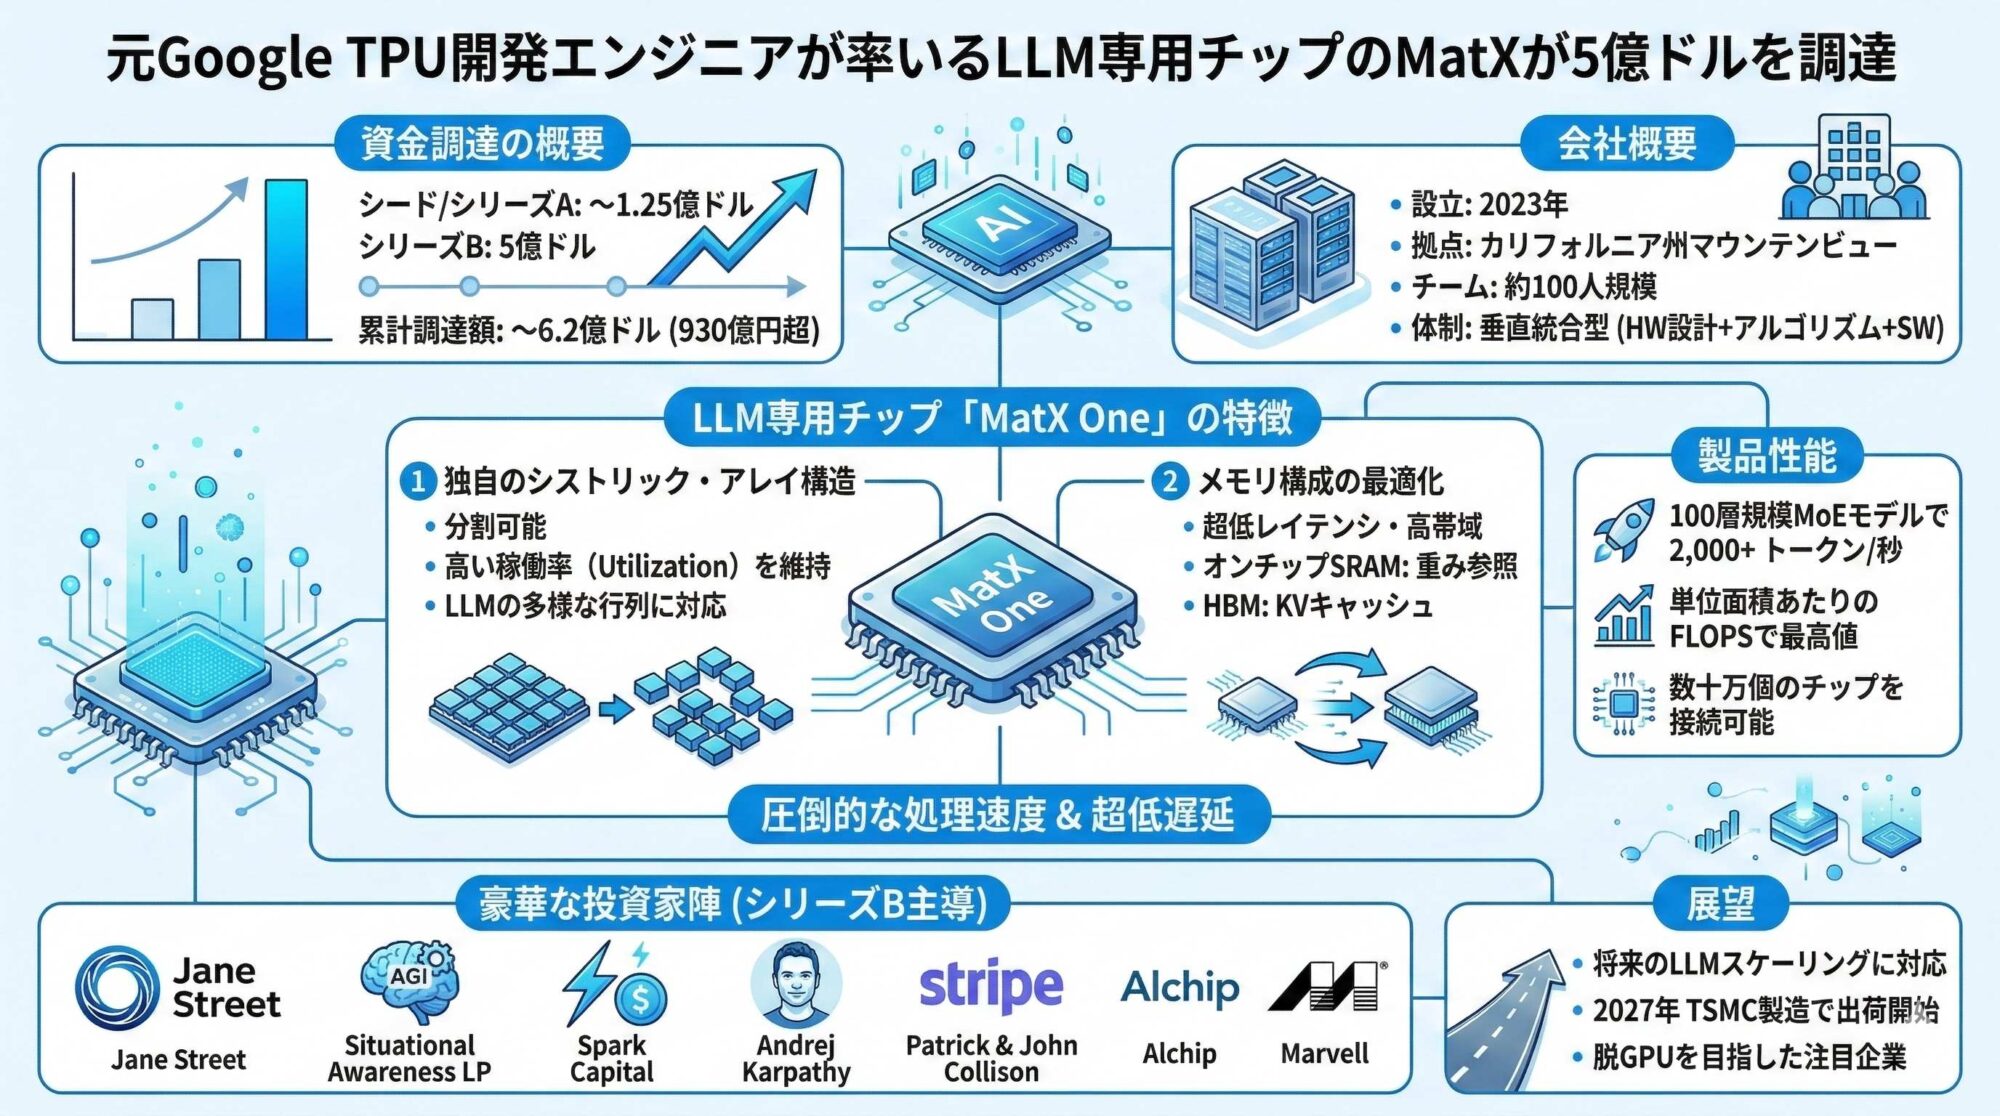
2026年2月24日、LLM専用チップを手がける半導体スタートアップ米MatXは、5億ドルの資金調達を発表した。
MatXは2023年にGoogle TPUの開発者Reiner Pope (CEO)とMike Gunter (CTO)が設立した半導体スタートアップで、カリフォルニア州マウンテンビューに本拠を置く。
現在は約100人規模のチームで、ハードウェア設計に加え、アルゴリズム、ソフトウェア、実装技術などを含む垂直統合型の体制で開発を進めている。
同社はこれまでシード資金、資金調達シリーズAで約1億2,500万ドルを調達しており、今回の資金調達を合わせると累計調達額は約6億2,000万ドル(930億円超)となる。
MatXが開発するのは、次世代の大規模言語モデルに特化したAIチップ「MatX One」で、既存のAIチップを凌駕する圧倒的な処理速度と超低遅延の両立を目指している。MatXは「小さなモデル、畳み込み、レコメンダー」などはターゲットにしないと明言しており、汎用性をあえて排除した独自のアーキテクチャにより、LLMにおいて発表済みのどのシステムよりも高いスループットを実現し、同時にSRAMファーストの設計に匹敵する低レイテンシを提供するとしている。
「MatX One」のアーキテクチャの特徴として挙げられるのは、独自のシストリック・アレイ構造とメモリ構成の2つ。「MatX One」のシストリック・アレイは、Google TPUのような巨大なシストリック・アレイと異なり「分割可能」な構造となっており、巨大アレイが持つエネルギー・面積効率を維持しつつ、LLM特有の多様な行列形状に対しても高い稼働率(Utilization)を維持できる柔軟性を備えている。
メモリは、HBMを中心とするGPU/TPUとは異なり、オンチップSRAMとHBMを使い分け、LLMで毎トークン繰り返す重み参照を超低レイテンシ・高帯域のSRAMでさばき、KV(Key/Value)キャッシュはHBMに置くという形を取る。これによりSRAM並のレイテンシとHBM並の長文対応の両方を実現するという考え方だ。
MatXは、「MatX One」のパフォーマンス指標として、100層規模の巨大なMoE(Mixture of Experts)モデルにおいて、1秒間に2,000トークン以上の出力を実現するという圧倒的な推論速度を示している。また、詳細は明らかにされていないが、単位面積あたりのFLOPS(演算性能)で最高値を記録し、数十万個のチップを接続できるインターコネクト技術も実装しているということだ。
また、特筆すべきはMatXに賭けた投資家達の顔ぶれで、シリーズBの5億ドルを主導したのは、ウォール街で最も技術に精通した投資銀行と呼ばれるJane Streetと、AGIにフォーカスした投資会社Situational Awareness LPの2社。さらに、Spark Capital(ユニコーンへの早期投資で有名、Anthropicにも投資)、Andrej Karpathy(元Tesla AI責任者、OpenAI創設メンバー)、Patrick & John Collison(Stripe共同創業者)、Alchip、Marvellなど、豪華な投資家陣が名を連ねている。
「モデルのサイズに上限はない」と言い切り、将来的なLLMのスケーリングにも対応できるとされる開発中の「MatX One」は、2027年にTSMCの製造による出荷が開始される予定。
脱GPUを目指した推論チップが乱立し、巨額の資金が注ぎ込まれる中で、MatXは注目すべき1社であることは間違いないが、チップ単体のピーク性能だけでなく、ソフトウェア・スタックやネットワークも含めたラックレベルのシステムとして、どこまで市場で戦うことができるか。まずはその土俵に立つための量産開始を見守りたい。
MatX
= EDA EXPRESS 菰田 浩 =
(2026.03.06
)